最近,大名鼎鼎的 Firecrawl 开源了一个名为 anydoc 的项目,值得聊一聊。
以前,如果想把一份 DOCX 手动转成文本再喂给模型,用 LibreOffice 光转换就得等一秒多,还不算手动操作的时间。anydoc 把这个过程压到了中位数 4.4 毫秒,覆盖全部 14 种常见格式,并输出统一的 GitHub-Flavored Markdown。
它不是又一个"够用就行"的转换器。Firecrawl 用纯 Rust 重写了整条流水线,把 Word、PowerPoint、Excel、OpenDocument、RTF、EPUB、CSV 和 PDF 统统纳入同一个文档模型,再统一序列化。结果是:无论你丢进去的是 2003 年的老 .doc,还是昨天刚导出的 .pptx,标题层级、合并单元格、脚注和任务列表,输出都长一个样。全程本地运行,不依赖外部服务,也不需要机器学习模型。
很多人以为,文档解析要么靠东拼西凑一堆工具,要么直接上云。实际上,这样的速度和质量完全可以在本地实现。anydoc 已经在支撑 Firecrawl 自家的 Parse 端点,只有扫描版 PDF 才会额外走 OCR,纯文本 PDF 和 Office 文档都是本地一次性搞定。
不过,官方基准测试无法复现——README 里自己写明了:那 100 个测试文件不可再分发,也不包含在仓库中。
所以我改用自己的文件:每种格式 40 个,每个不超过 25 MB。
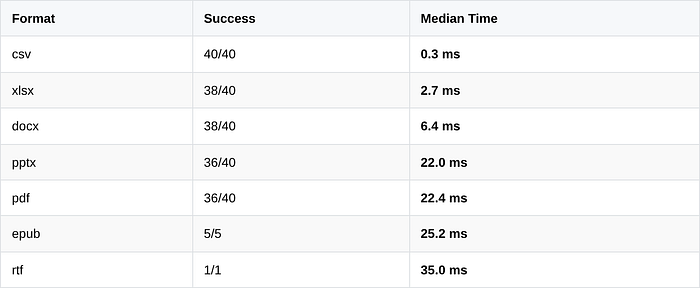
总共 206 个文件,194 个成功。
官方宣称中位数低于 5 毫秒,实测只有 CSV 和 XLSX 达标:DOCX 为 6.4 毫秒,PPTX 和 PDF 都是 22 毫秒。最慢的一个 PPTX 花了 346 毫秒——那是样本中一个两百多 MB 的大文件。所谓"5 毫秒"其实是整个语料库的混合中位数,被 CSV 这类可以逐行读取的格式严重拉低了。
换算成实际场景:1000 个 DOCX 文件大约 6 秒转完,1000 个 PPT 文件则要二十多秒。都够快,但做规划时应该以后者为准。
失败的 12 个文件里,有 8 个错不在 anydoc。
我把这 8 个报 malformed 的文件挑出来,用 file 命令跑了一遍:两个 .docx 中,一个被识别为 data,另一个是 JSON data;两个 .xlsx 和四个 .pptx 则全是 data。
换句话说,它们根本不是 Office 文件。anydoc 按内容识别格式、不认扩展名,所以没被骗过。
去掉这 8 个"假货",真实成功率是 194/198,即 98%。
这次测试还有个意外收获:我的硬盘里居然躺着一堆扩展名造假的文件,连我自己都不知道。用 anydoc 扫一遍文档库,把报 malformed 的挑出来,就能得到一份现成的损坏文件清单。它本来不是干这个的,但确实好使。
为什么现有工具让你抓狂
想把一份合同丢给模型,第一步就得先搞清楚"这文件到底是什么格式":扩展名写着 .docx,实际内容却可能是个改了后缀的 ZIP;CSV 没有文件签名,只能手动指定。换一款工具,输出规则又是一套——表格时而变成列表,脚注说丢就丢,嵌套列表的缩进也会乱。
LibreOffice 的转换中位数超过 1100 毫秒,而且连 14 种格式都覆盖不全;unstructured、markitdown、pandoc 各管一摊,质量得分最高也就 65 上下。anydoc 在同一批 100 个真实文档上拿到总分 81——完整性 87、结构 79、格式 78、整洁度 81,速度大约快 250 倍。
这不是实验室里的数字:500 个 DOCX 文件 1.7 秒全部转完,完全可以直接插进 Agent 循环里。以前得搭异步队列等回调,现在连同步调用都觉得快。
我自己也丢了一堆老 .xls 和 .odp 文件试它:有些文件名和实际格式对不上,它照样靠文件头认了出来;像 CSV 这种没有签名的格式,则必须明确告诉它"这是 CSV",否则就会跳过。这些小细节挺有意思。
速度与质量如何兼得
每种格式先做内容检测:PDF 看文件头,RTF 看分组,ZIP 看 mimetype。识别出来之后进入各自的专属解析器,再统一喂进 Document 模型——块、内联、表格、脚注、嵌入资源,全都在里面。最后,所有内容经过同一个 GitHub-Flavored Markdown 序列化器输出。
因此,表格的单元格合并、标题锚点、删除线、代码块、演讲者备注,全部遵循同一套规则。图片和嵌入对象会变成带 alt 文本的 Markdown,但原始字节仍保留在模型里,需要时可以取回。
PDF 由 pdf-inspector 处理,且只认带文本层的:纯扫描件直接报 Unsupported,不假装能读;加密文件也会给出明确报错。这种"诚实",怎么都比尽力而为式的转换强。
纯 Rust 实现,没有 Python 解释器的开销,也不往磁盘写临时文件;Node 绑定使用 libuv 线程池,不阻塞事件循环;Python 侧则会释放 GIL。4.4 毫秒的中位数,就是这么来的。
当然,也有人觉得用 Rust 写解析器是过度工程;还有人直接把它装成 Agent 技能,让 Claude 或 Cursor 遇到文档时自己调用转换。两种用法各有拥趸。
上手只需一行
CLI 的用法最直接:
npx @firecrawl/anydoc report.docx
输出会直接打到终端;加上 -o slides.md 可以存成文件。如果要从 stdin 读取 CSV:
npx @firecrawl/anydoc - --format csv < data.csv
在 Node 中调用:
import { toMarkdown, toMarkdownBytes } from '@firecrawl/anydoc';

const md = await toMarkdown('report.docx');
const mdFromBytes = await toMarkdownBytes(bytes);
const mdCsv = await toMarkdownBytes(bytes, 'csv');
Python 也类似:
import anydoc

md = anydoc.to_markdown("report.docx")
md_bytes = anydoc.to_markdown_bytes(data)
md_csv = anydoc.to_markdown_bytes(data, "csv")
如果想在浏览器里运行,可以用 @firecrawl/anydoc-wasm,文件不会离开你的机器;Rust 项目则直接 cargo add anydoc。
Agent 场景更简单:npx skills add firecrawl/anydoc,从此以后,工具链一遇到文档就会自动调用它。
跑完之后,你会看到干净的 Markdown:表格、列表、标题都在。复杂文档偶尔会丢一些边角样式——那是解析器的取舍,不是崩溃。
需要提醒的是,anydoc 还处于 0.1.x 阶段,极端畸形的文件或超大的嵌入对象,理论上可能触发 ResourceLimit。生产环境最好按类别处理返回的错误:加密和不支持的格式单独记录,别让它们拖垮整条流水线。
一句话总结:能本地搞定的,就别绕云服务一圈;扫描件留给带 OCR 的端点。速度和质量都到位了,剩下的就看你怎么把它接进自己的流水线。